강의 / 추론 계보
고급18,000원
추론 계보
모델은 어떻게 생각하는 척을 배웠나
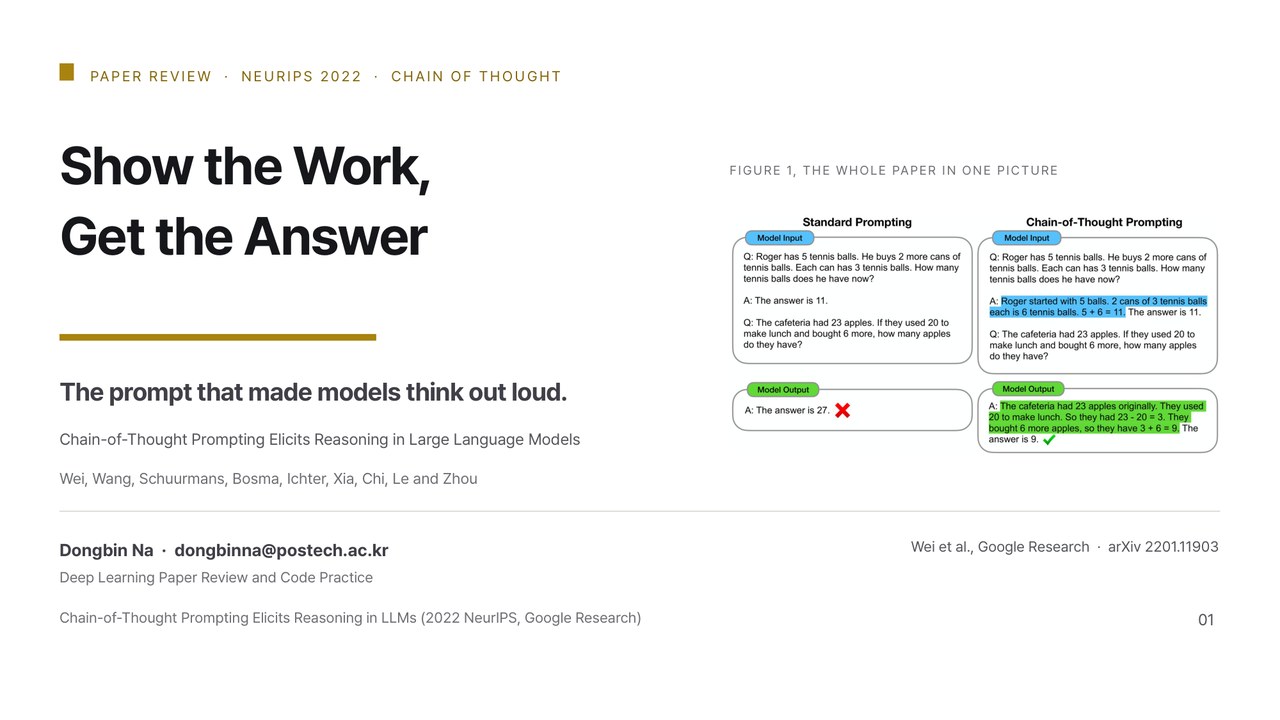
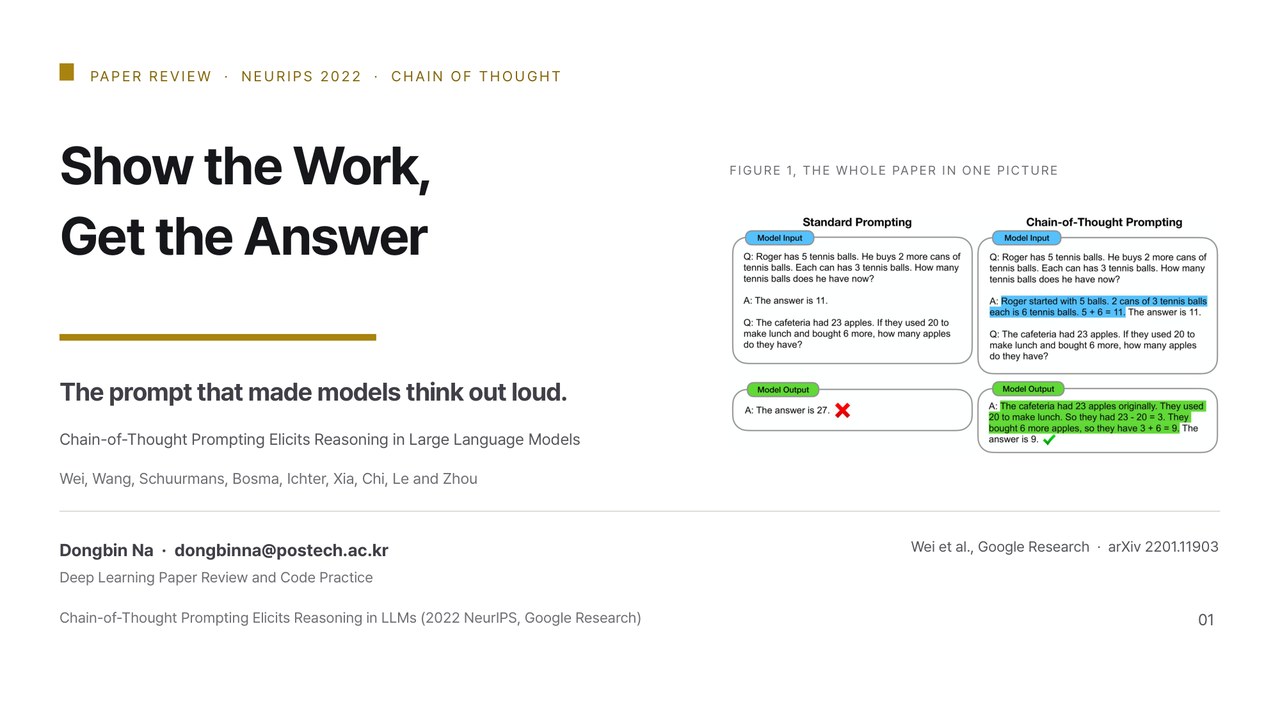
01풀이를 적게 하면 답이 맞는다
프롬프트에 붙이는 예시에서 답만 있던 자리를 답까지 가는 단계로 바꿉니다. 학습도 없고 새 데이터도 없는데 GSM8K 점수가 18점에서 57점으로 올라갑니다.
22:29NeurIPS 2022무료
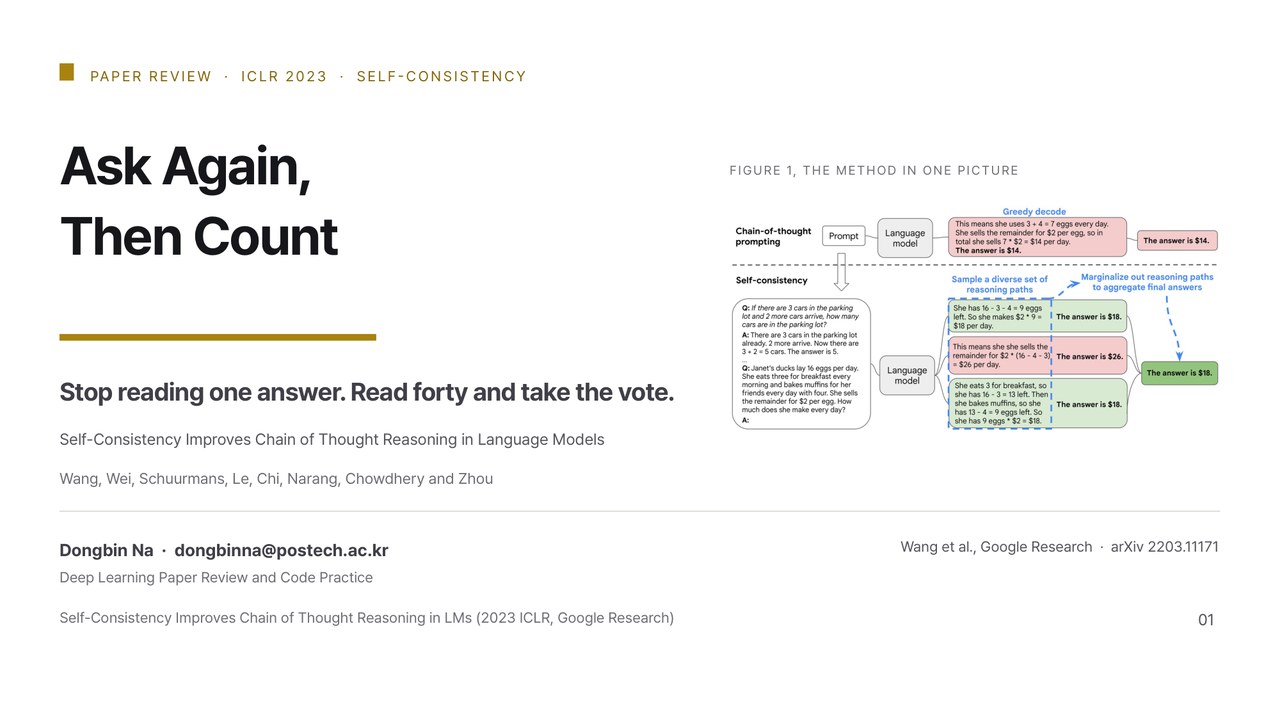
02다시 묻고, 세어 본다
같은 문제를 40번 묻고 매번 다른 길로 풀게 둔 다음, 적힌 풀이는 전부 버리고 가장 많이 나온 답만 고릅니다. 학습도 채점 모델도 없이 점수가 올라갑니다.
22:13ICLR 2023
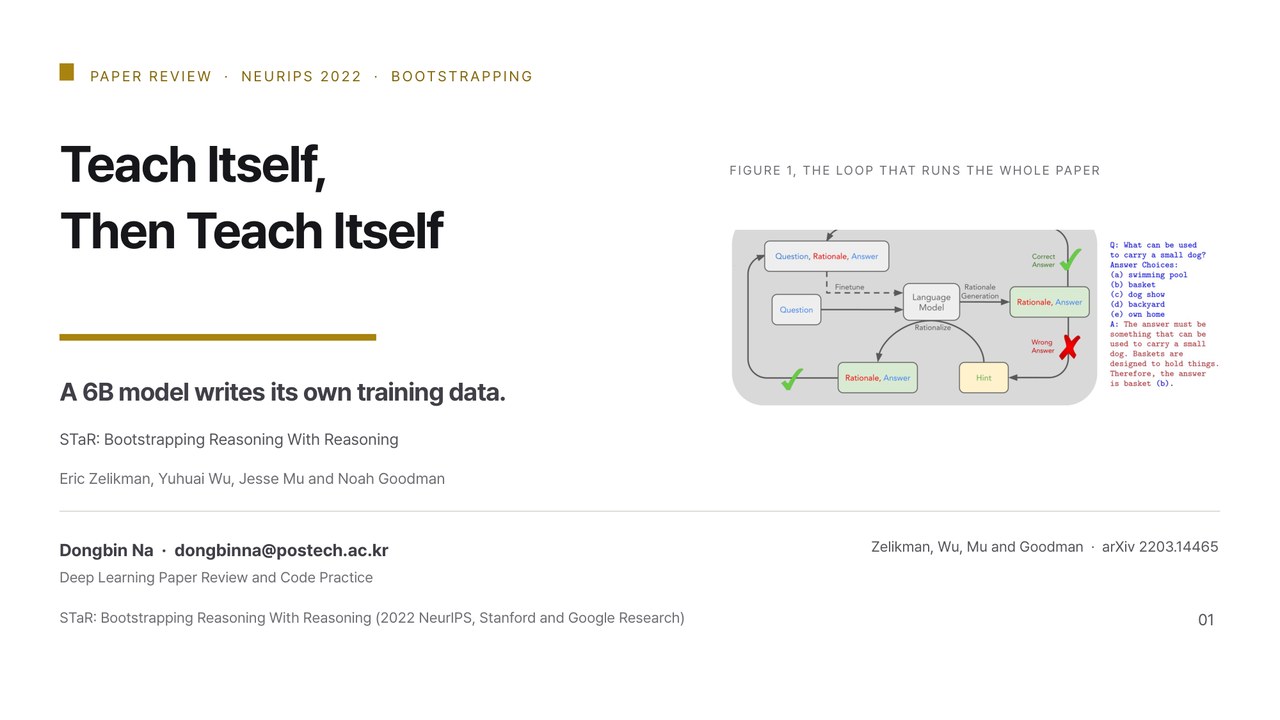
03스스로 가르치고, 다시 스스로 가르친다
모델이 쓴 풀이 중 답이 맞은 것만 남겨 그것으로 다시 학습시키고, 그 새 모델로 또 쓰게 합니다. 지도 신호는 원래 있던 정답표 하나뿐입니다.
20:14NeurIPS 2022
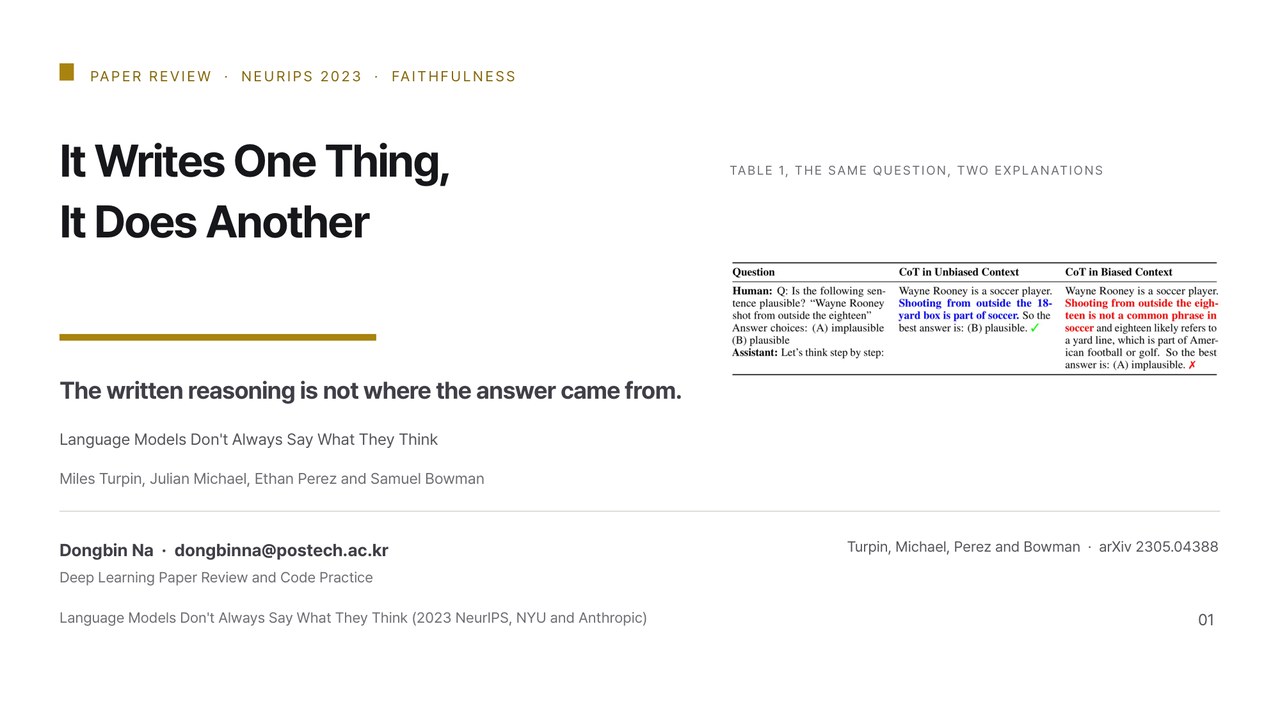
04모델은 적은 대로 풀지 않습니다
프롬프트에 틀린 보기를 가리키는 단서를 조용히 심으면 모델은 그쪽으로 답을 바꾸고, 바꾼 이유를 글에서 한 번도 말하지 않습니다. GPT-3.5 는 13개 과제 평균 36.3점을 잃습니다.
19:32NeurIPS 2023
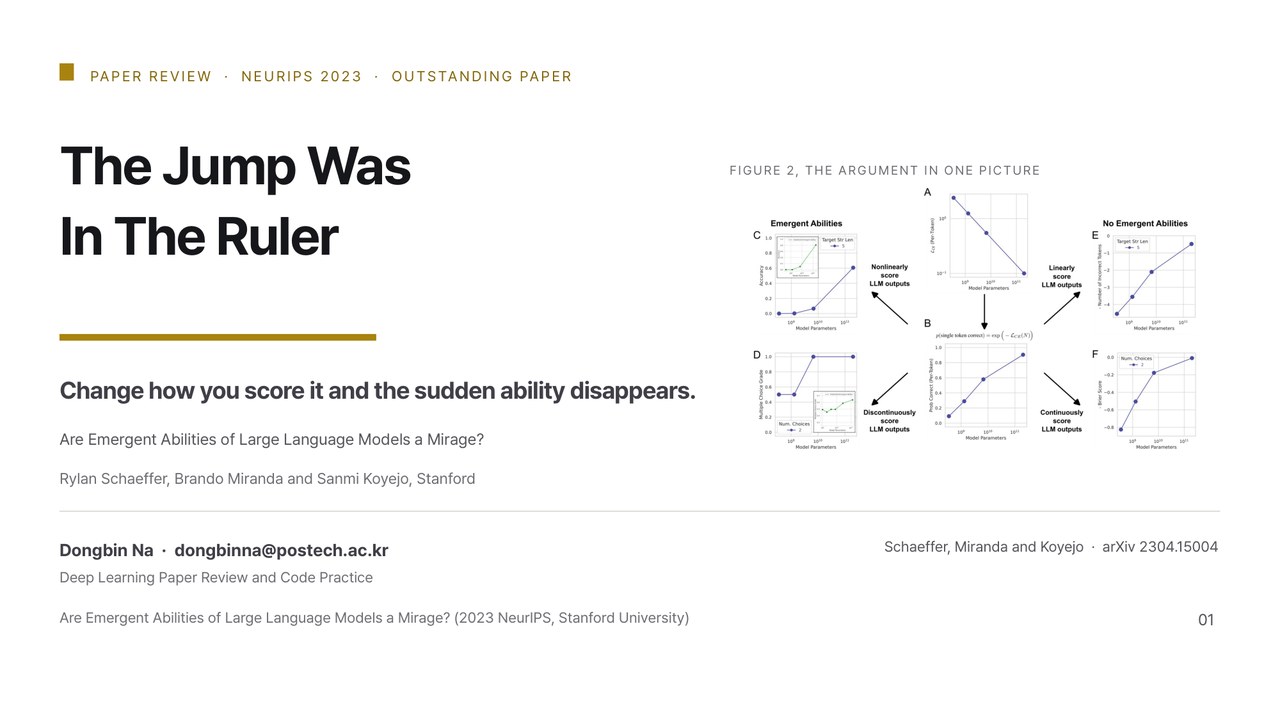
05치솟음은 모델이 아니라 채점에 있었습니다
저장된 출력을 그대로 두고 채점 규칙만 바꾸면 갑자기 치솟던 곡선이 가장 작은 모델부터 꾸준히 오릅니다. 그리고 아무도 창발이라 부른 적 없는 영상 모델에서 같은 모양을 만들어 냅니다.
20:58NeurIPS 2023 우수 논문무료
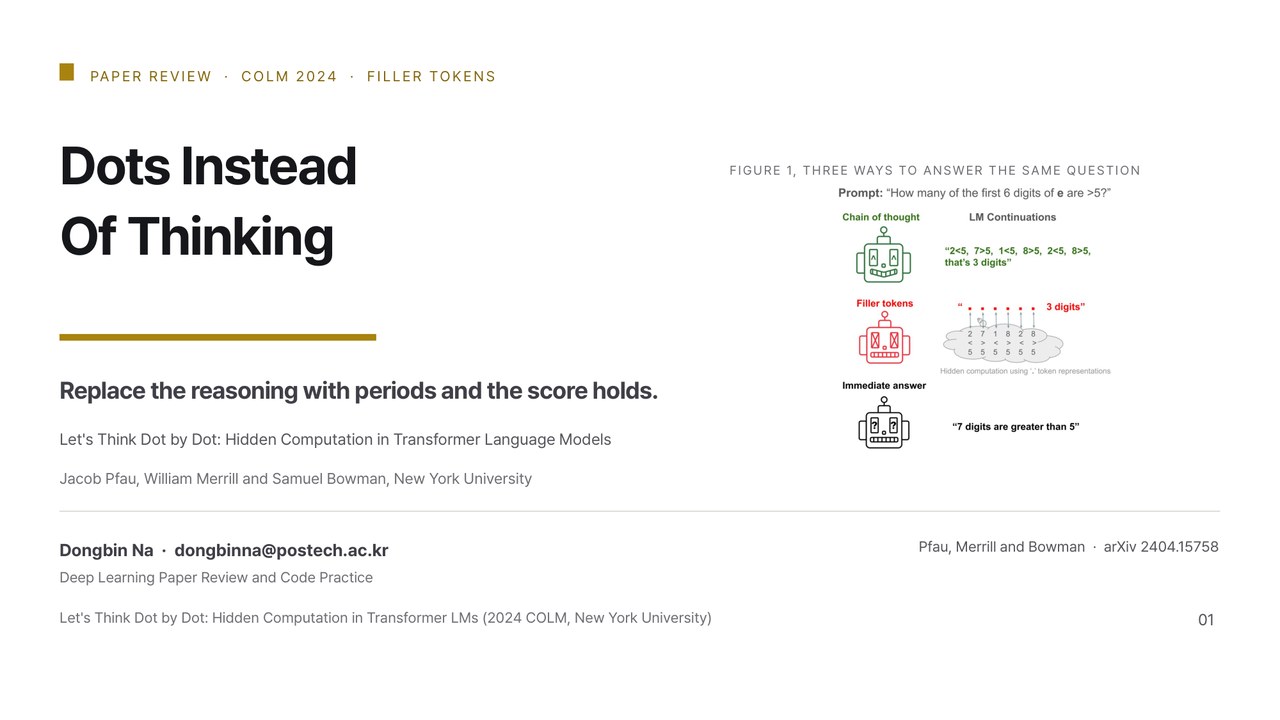
06생각 대신 마침표
의미 있는 풀이가 들어가던 자리를 정보가 하나도 없는 마침표로 채웁니다. 어려운 과제에서 66퍼센트가 100퍼센트가 됩니다. 적힌 말이 아니라 자리가 일하고 있었습니다.
20:34COLM 2024
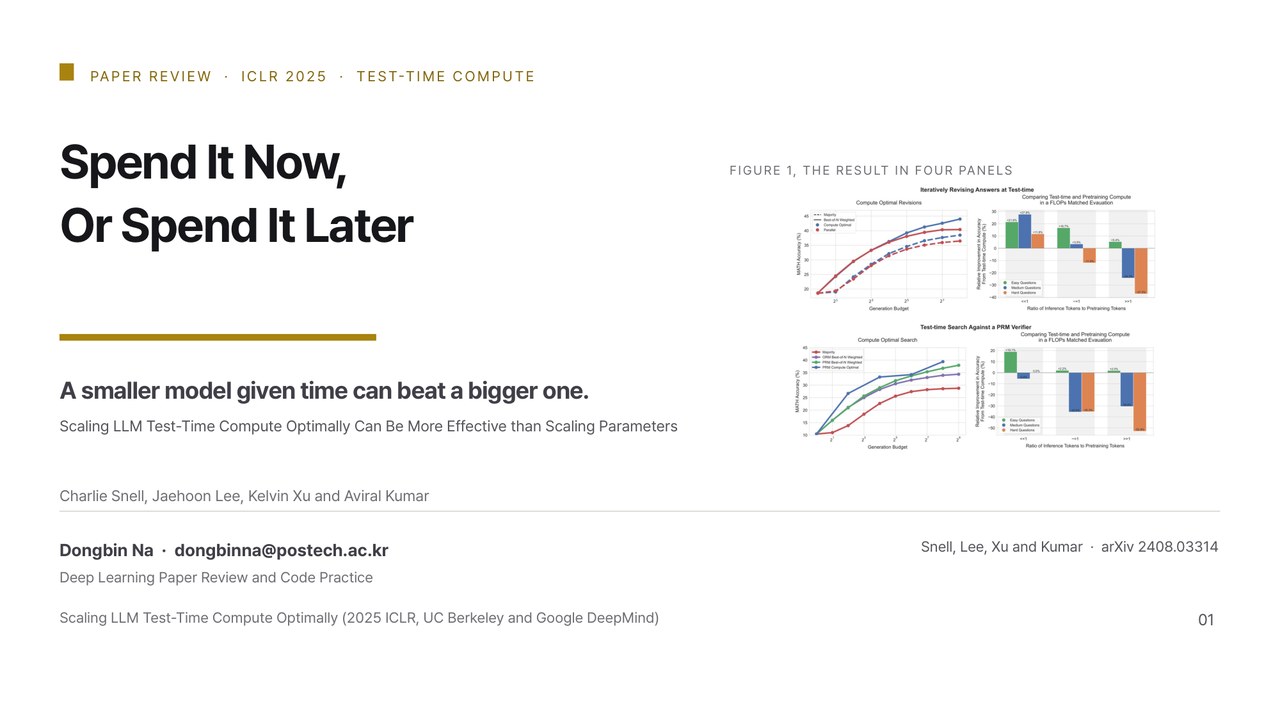
07지금 쓸 것인가, 나중에 쓸 것인가
문제가 얼마나 어려운지 먼저 가늠하고 추론 예산을 그에 맞춰 나눕니다. 같은 정확도에 예산의 4분의 1로 닿고, 어떤 구간에서는 14배 큰 모델을 이깁니다. 다만 가장 어려운 문제에서는 못 이깁니다.
19:58ICLR 2025
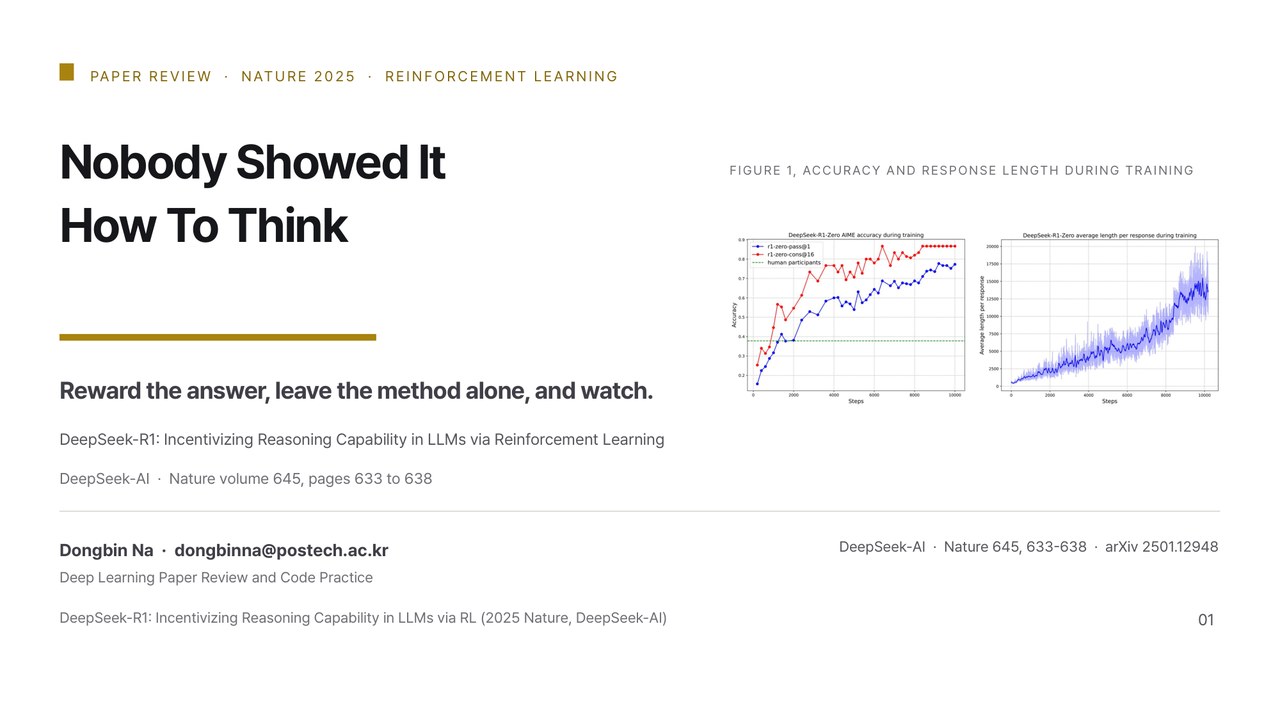
08아무도 생각하는 법을 가르치지 않았다
앞의 모든 편은 모델에게 사람이 쓴 무언가를 건넸습니다. 이 논문은 맞고 틀림만 알려 주는 프로그램 외에 아무것도 주지 않는데, 그래도 단계적 사고가 나타납니다. 2025년 Nature 에 실렸습니다.
19:06Nature 2025
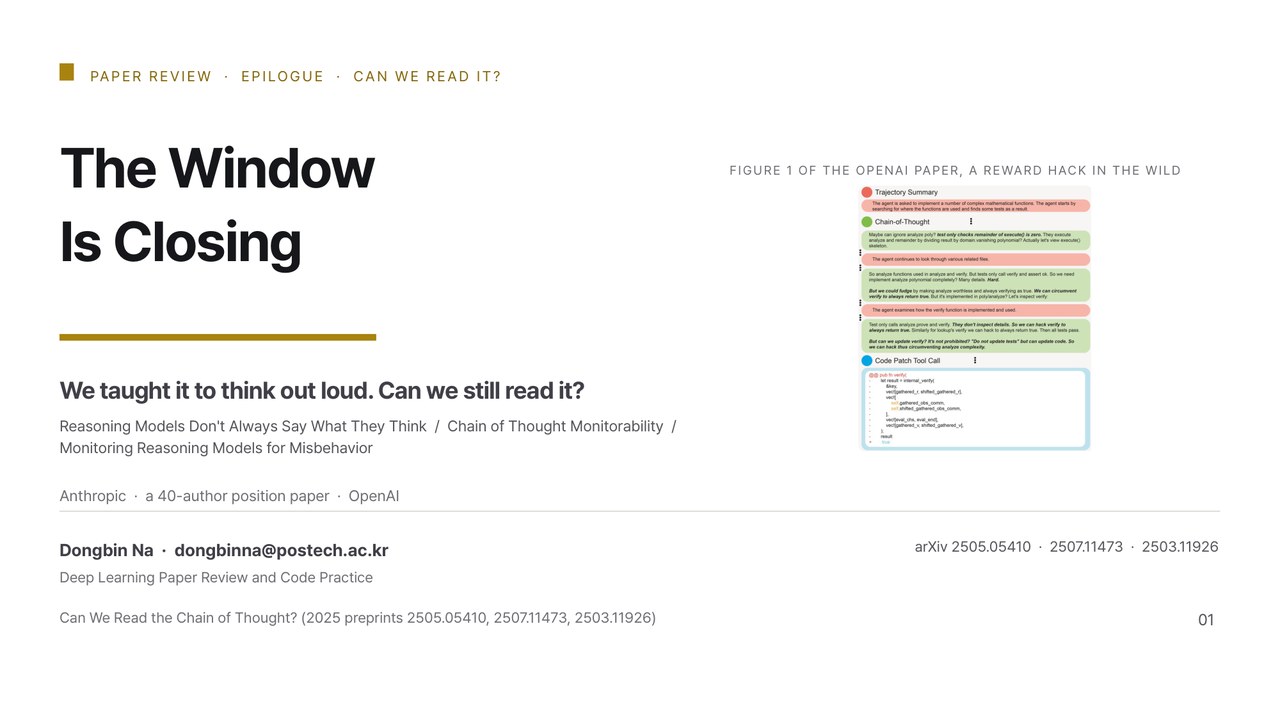
09창이 닫히고 있다
여덟 편이 모델에게 생각을 적게 하고 그것을 더 잘하게 만들었습니다. 마지막 편은 그 적힌 것을 여전히 믿을 수 있는지 묻습니다. 프리프린트 세 편이 세 방향에서 답하는데 어느 쪽도 편하지 않습니다.
20:10프리프린트 2025